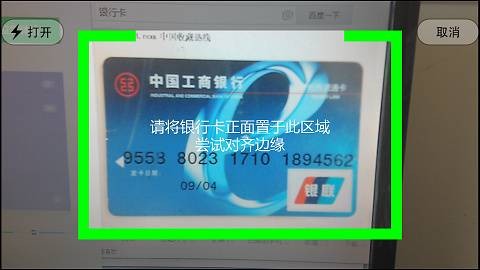
OCR字符识别是指电子设备(例如扫描仪或数码相机)检查纸上打印的字符,然后用字符识别方法将形状翻译成计算机文字的过程;即,对文本文档进行扫描,然后对图像文件进行分析处理,获取文字及版面信息的过程。光学文字识别的概念是在1929年由奥地利科学家Gustav Tauschek最先提出来的 。
第一个OCR软件是在1957年开发的ERA (Electric Reading Automation)。OCR技术的发展可分为三个阶段:第一代OCR产品出现于60年代初期;第二代产品基于手写体字符的识别;第三代产品主要解决质量较差的文档及大字符集的识别,例如汉字的识别。我国在OCR技术方面的研究工作起步较晚,在70年代才开始对数字、英文字母及符号的识别进行研究 。当前OCR技术采用CRNN等深度学习架构,支持多语言混合识别,并广泛应用于古籍数字化、工业物流等多个领域 。
想要了解更多“OCR字符识别”的信息,请点击:OCR字符识别百科